第 6 章
消息队列和应用工具产品体系(一)
第 4 章讲了微服务和 Serverless。这一章看服务怎样协作、怎样承接突发流量,先从消息队列开始。
系统要守住哪些指标
在讲具体产品之前,先明确一下"系统好不好"是拿什么衡量的,这几个指标是这一整章内容存在的意义:
- 可用性:系统能正常对外服务的时间比例,常说的"几个 9"就是这个——99.9%(三个 9)一年大概能容忍 8.7 小时故障,99.99%(四个 9)只能容忍约 52 分钟
- 性能:响应时间(一次请求要多久)、吞吐量(单位时间能处理多少请求,常用 QPS 衡量)
- 可扩展性:流量涨了,能不能通过加机器/加实例线性地把处理能力提上去
- 可靠性:数据会不会丢、消息会不会重复处理
后面要讲的消息队列、限流降级、混沌工程、监控,都是为了让这几个指标在真实的高压场景下依然达标。
同步调用为什么会被拖慢
设想一个电商大促场景:瞬时涌入的下单请求远超平时几十倍。如果上游服务直接同步调用下游(比如下单服务直接同步调用库存服务、支付服务),会出现:
- 下游处理能力跟不上,请求在下游堆积、超时
- 超时的请求还占着上游的连接和线程资源没释放,上游自己也开始变慢
- 压力沿着调用链一级一级往上传导,最终演变成第 1 章提过的级联故障(雪崩)
同步调用需要等待下游返回。如果请求持续超过处理能力,又没有限流、超时和隔离措施,等待就可能耗尽资源。能延后处理的业务,可以考虑通过消息异步交接。
微服务把一个大应用拆成了几十上百个小服务,如果这些服务之间还是两两同步调用、强依赖,问题只会被放大:任何一个服务的抖动,都可能顺着调用链影响一大片本来毫不相干的功能。
需要一种机制,把"实时的强依赖"变成"异步的弱依赖"——这正是消息队列要解决的问题。
消息怎样交给下游
消息队列围绕几个核心角色展开:
- 生产者(Producer):发送消息的一方
- Broker:接收、保存和分发消息的服务端
- 消费者(Consumer):订阅并处理消息的一方
- Topic(主题):给消息分类的逻辑通道,生产者发到某个 Topic,消费者订阅它
- 消费者组(Consumer Group):协作消费的一组消费者;集群消费时,组内实例分担消息,不同组可以分别订阅同一主题
生产者不用等消费者完成业务,但“发送成功”与“消费完成”是两回事。例如同步发送仍要等待 Broker 的发送结果,异步发送则通过回调得知结果,不能把它们都理解成“发完就立刻成功返回”。RocketMQ 发送方式说明了这一区别。
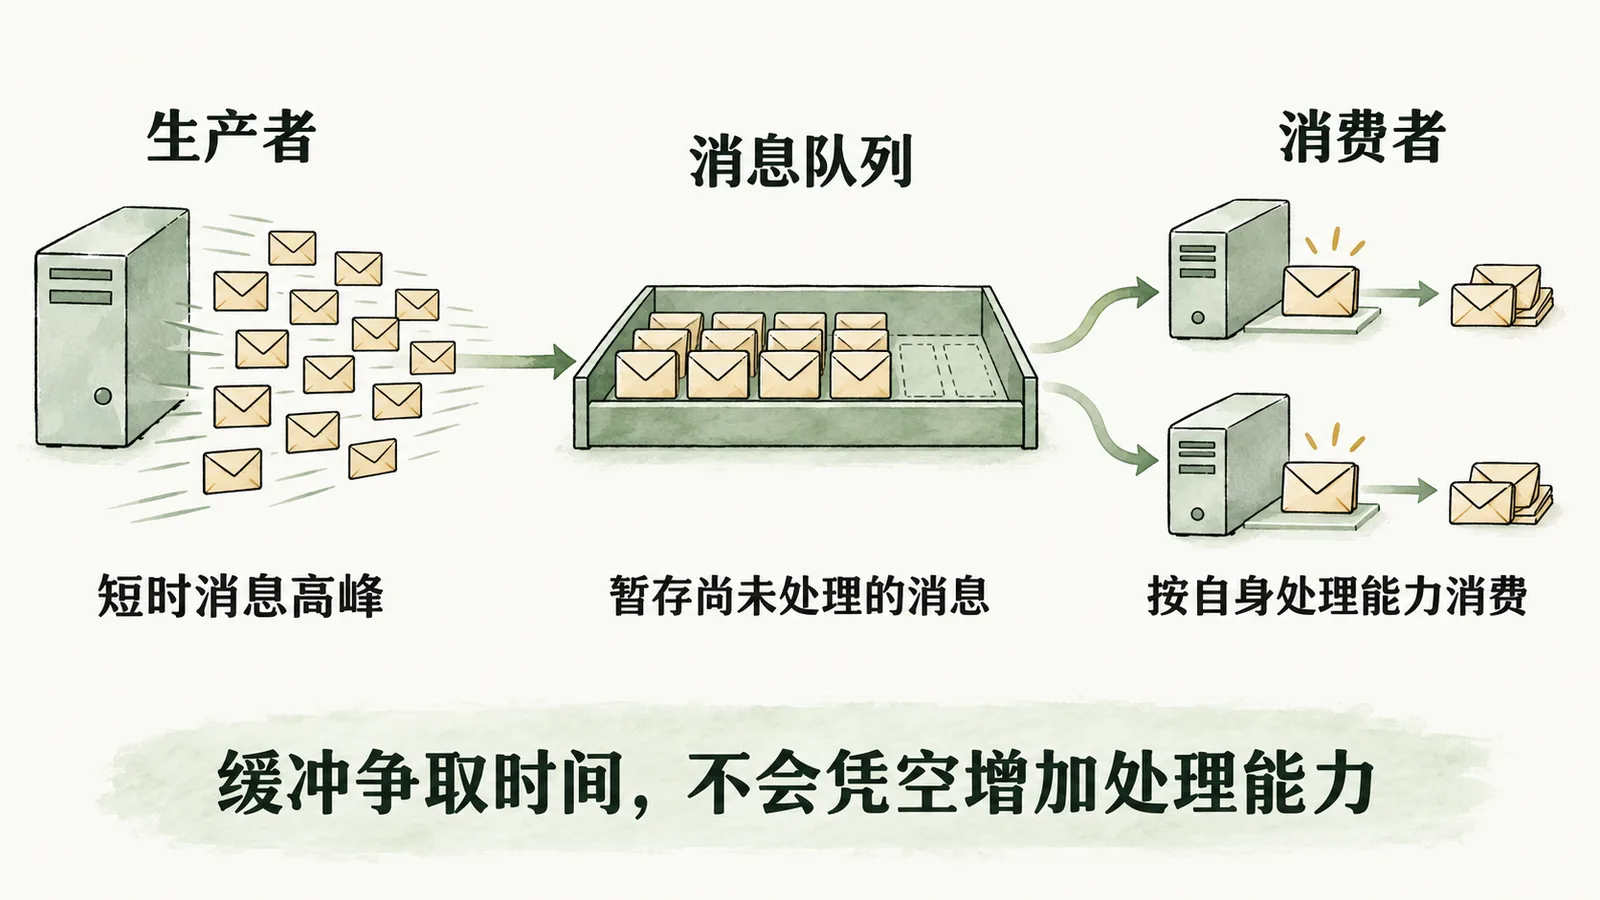
缓冲不提高下游的处理上限。若输入长期大于消费能力,积压和端到端延迟仍会增长,需要优化或扩容消费者、减小输入;扩容还受队列数量等条件限制。消息也可能重投,业务端仍要考虑幂等。RocketMQ 消费者与消费组有相应说明。
一条消息被某个组处理后,不代表其他订阅组也处理完了。RocketMQ 为各组保存消费进度,消息不会因为某一组消费完成就立即从存储中删除,见消费进度管理。
RocketMQ 与 Kafka 怎么选
阿里云的消息队列产品家族里,最核心的两个是消息队列 RocketMQ 版和消息队列 Kafka 版,都是把对应的开源引擎做成全托管服务——免去自建集群的运维成本,同时保持和开源协议兼容。
RocketMQ:业务消息
RocketMQ 是阿里巴巴 2012 年自研的消息中间件,最初是为了扛住淘宝内部万亿级的消息处理量而设计的,同年就开源了第一个版本。2015 年陆续补上事务消息、定时消息、消息轨迹追踪等重量级功能。2016 年,阿里把 RocketMQ 捐给 Apache 基金会,仅用 10 个月就在 2017 年毕业成为 Apache 顶级项目——是中国第一个非 Hadoop 生态的 Apache 顶级项目。
它的核心能力:
- 低延迟、高可靠:消息落盘采用顺序写(commitlog 单文件顺序写入),具体延迟仍要结合消息大小、持久化策略和负载测试
- 事务消息:原生支持——这正是第 1 章提到的分布式事务几种方案之一,能保证"发消息"和"改本地数据库"这两个操作的最终一致性
- 顺序消息、定时/延时消息、死信队列:应对各种业务场景里对消息顺序和时效性的要求
阿里云托管版本相比自建,省掉的是集群运维、多可用区容灾这些重活,用户只需要关心 Topic 和消息本身。
RocketMQ 最典型的定位是业务消息:订单状态变更通知、支付结果回调、库存扣减这类和交易强相关、对可靠性和事务性要求高的场景。
Kafka:事件流
Kafka 源自 LinkedIn 开源,核心特点是超高吞吐量——它的存储模型基于顺序追加的日志(log),Partition(分区)数量可以按需扩展,每个 Partition 独立顺序写,天然适合海量数据的高吞吐写入。
阿里云 Kafka 版是全托管服务,兼容开源 Kafka 协议,已经在用开源 Kafka 的应用基本不用改造代码就能迁移过来。
它最典型的定位是海量数据管道:日志采集聚合、大数据实时处理、流式计算的输入源,这些场景对吞吐量的要求远高于对复杂事务语义的要求。
选型时看什么
| 关注点 | RocketMQ | Kafka |
|---|---|---|
| 消息语义 | 核对事务消息、顺序消息、定时/延时与重试等需求 | 核对分区内顺序、消费回放、幂等与事务等需求 |
| 生态衔接 | 订单、支付等业务消息,以及上下游的消费处理 | Kafka Connect 数据连接、Kafka Streams 流处理等 |
| 典型场景 | 订单、支付、库存这类业务消息 | 日志采集、大数据管道、流处理 |
备考时可以先用“业务消息 / 数据管道”分辨常见定位;实际选型不能据此断言哪一个一定延迟更低、吞吐更高。消息大小、批处理、持久化策略和部署资源都会影响结果,要用自己的负载验证。
Kafka 也能通过 Kafka Streams 做流处理,不能笼统记成“只搬运、不计算”;但消息平台、分析引擎和 CDN 仍承担不同职责。Kafka 官方介绍列出了事件存储、订阅和处理的边界。
消息队列让服务之间松耦合、缓冲流量尖峰,但故障依然会发生。下一节看限流、熔断、降级和混沌工程。